项目 03 / 04 · 工具
参考文献核查器
refcheck
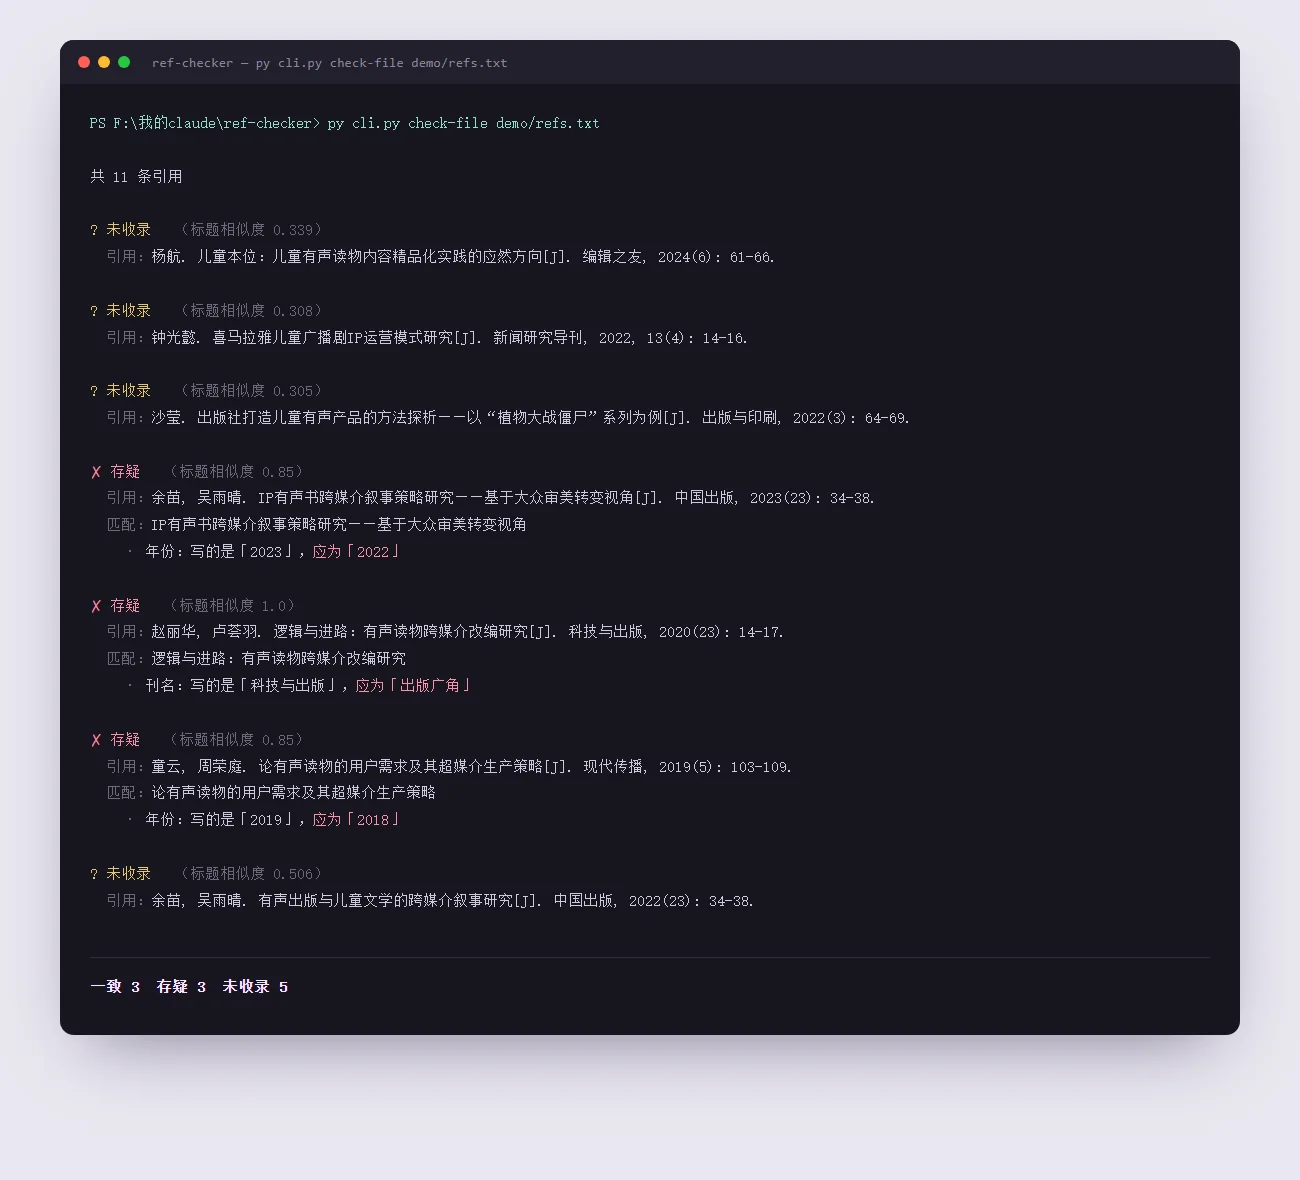
把论文里手写的参考文献,拿去和自己逐条核对过的文献库比对, 指出年份、作者、刊名、期号、页码里哪一处写错了,并给出正确值。
✗ 存疑   (标题相似度 1.0)
  引用:赵丽华, 卢荟羽. 逻辑与进路:有声读物跨媒介改编研究[J]. 科技与出版, 2020(23): 14-17.
  匹配:逻辑与进路:有声读物跨媒介改编研究
    · 刊名:写的是「科技与出版」,应为「出版广角」
它跑起来是这样
项目说明 · 四段
一、为什么做这个
我在写一篇关于儿童有声出版 IP 的论文,整理文献时留了一份手工清单。 清单开头是我自己写的一行字:
标注「待核」的条目元数据(刊期/页码/作者)未完全坐实,用前请在知网/万方核对。
手工核对 40 条引用,逐条回知网翻刊期页码,是那种又慢又容易出错、 还看不出做到哪一步的活。
更麻烦的是另一件事:大模型在这件事上不可信。 它会一本正经地编出一条格式完美、DOI 看起来也对的假引用。 在学术写作里,一个编造的引用比一个明显的空缺危险得多 —— 因为空缺你看得见,编造你看不见。
二、一个走不通的路,决定了整个设计
最自然的做法是去查外部数据库。实测下来这条路在国内直接堵死: CrossRef 的 API 在这台机器上完全不通,请求超时返回 HTTP 000。
于是核查的依据只剩一个来源:我自己手里那批已经人工核对过的记录。 这个约束反过来决定了工具的全部性格 —— 既然依据是有限的,那么「没有依据」和「核对通过」就必须严格分开。
库里那条记录没写年份,年份就报「无法核对」,而不是猜一个填上。 这条规矩看起来像废话,但它决定了工具可不可信: 如果把两者混为一谈,工具会对一半的引用说「没问题」,而那句话里没有任何信息量。
三、留一个基线,和一套自己打自己的评测
评测分两集。第一集是从真值库派生的常规集(231 条), 跑出来检出率 100%、误报率 0%。我的第一反应不是高兴,是怀疑评测。
原因很直接:常规集是用解析函数的逆运算生成的。 拿 A 的逆运算出题、再用 A 去考,必然接近满分 —— 测的不是能力,是自洽。
于是补了第二集:165 条全部手写构造,专挑解析器没被设计来处理的写法 —— 英文作者带缩写点、卷号插在年份和期号之间、标题被截短、年份整个缺失、多处同时错。 结果难看很多,但那才是真实水平。
同时留了一个朴素基线作对照:不做任何归一化、标题精确匹配的第一版实现。 留基线不是凑数 ——「我做了归一化,效果更好了」是一句形容词, 而「误报率从 59.2% 降到 4.9%」是一个数字。
四、评测先跑,再改代码
这个项目里最有用的一个习惯:把评测当成定位 bug 的手段,而不是写完之后的验收步骤。
两个最实的 bug 都是评测逼出来的。第一个是顿号: 解析器切分作者时只认逗号、中文逗号和分号,不认顿号 、, 而中文写作里「余苗、吴雨晴」极其常见 —— 12 条误报加 34 条定位错误全部来自这一处,根因只有一行正则。
第二个是缺年份:引用里没写年份时,页码会黏在刊名后面被整段当成刊名。 修的顺序只是「先摘页码,再取年份和刊名」, 缺年份这一类的通过率从 61.1% 变成 100%。
评测结果
两集都要看
只看常规集会得出「完美」的错误结论,只看难集会低估工具。 两集并列,才是这个东西的真实位置。
| 指标 | 常规集 · 基线 | 常规集 · 正式 | 难集 · 基线 | 难集 · 正式 |
|---|---|---|---|---|
| 错误检出率 | 79.4% | 100% | 88.7% | 100% |
| 误报率 | 36.8% | 0.0% | 59.2% | 4.9% |
| 定位准确率 | 59.5% | 100% | 66.7% | 100% |
| 实核字段数 | 1.99 | 2.61 | 1.14 | 2.13 |
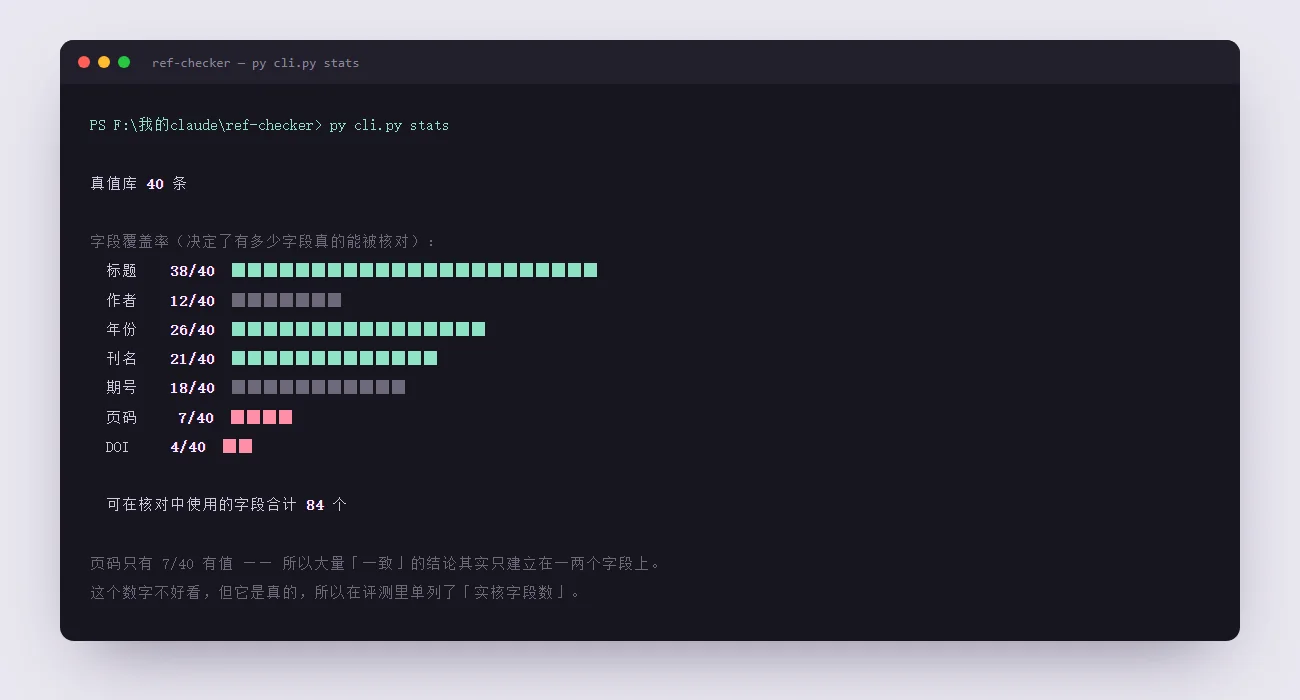
「实核字段数」指平均每条引用真正被比对到的字段个数。 真值库里作者只覆盖 12/40、页码 7/40,所以大量「一致」结论其实建立在两个字段上。 这个数字不好看,但它是真的 —— 所以在页面上一并写出来。
已知不足
它做不到什么
这一节比上面所有数字都重要。 一个没有「已知不足」章节的项目,通常意味着作者没测过边界。
- 0 / 3英文作者缩写点这一类完全通过不了。句点既是缩写点又是分隔符,靠局部规则无法区分。没修,因为真值本身也有歧义,为一个边缘案例放宽规则会危及中文文献这个真实用例。
- 2 / 38标题被截短时相似度跌破匹配阈值,被误判成「未收录」而不是「标题写错了」。阈值是拍脑袋定的,没调过。
- 2.61实核字段数偏低。要提升这个数字只能靠把文献库补全,不是靠改代码。
- 合成常规集是合成的,模拟的是单字段错误,而真实错误的分布是未知的。难集补了一部分,但仍不是真实分布。
- 无第三方验证真值库来自我自己的 Zotero,只保证经过人工核对,不保证绝对正确。工具的上限就是这份库的质量。
结果
它证明了什么
一个工具可不可信,不取决于它有多聪明,取决于它知不知道自己不知道什么。 这个项目从头到尾只做了一件事:把「有依据的判断」和「没依据的猜测」严格分开, 然后把这条规矩贯彻到评测指标里。
下一步最有性价比的事不是改代码,是把真值库从 40 条补到 200 条以上 —— 目前所有指标的上限都卡在这份库的覆盖率上。